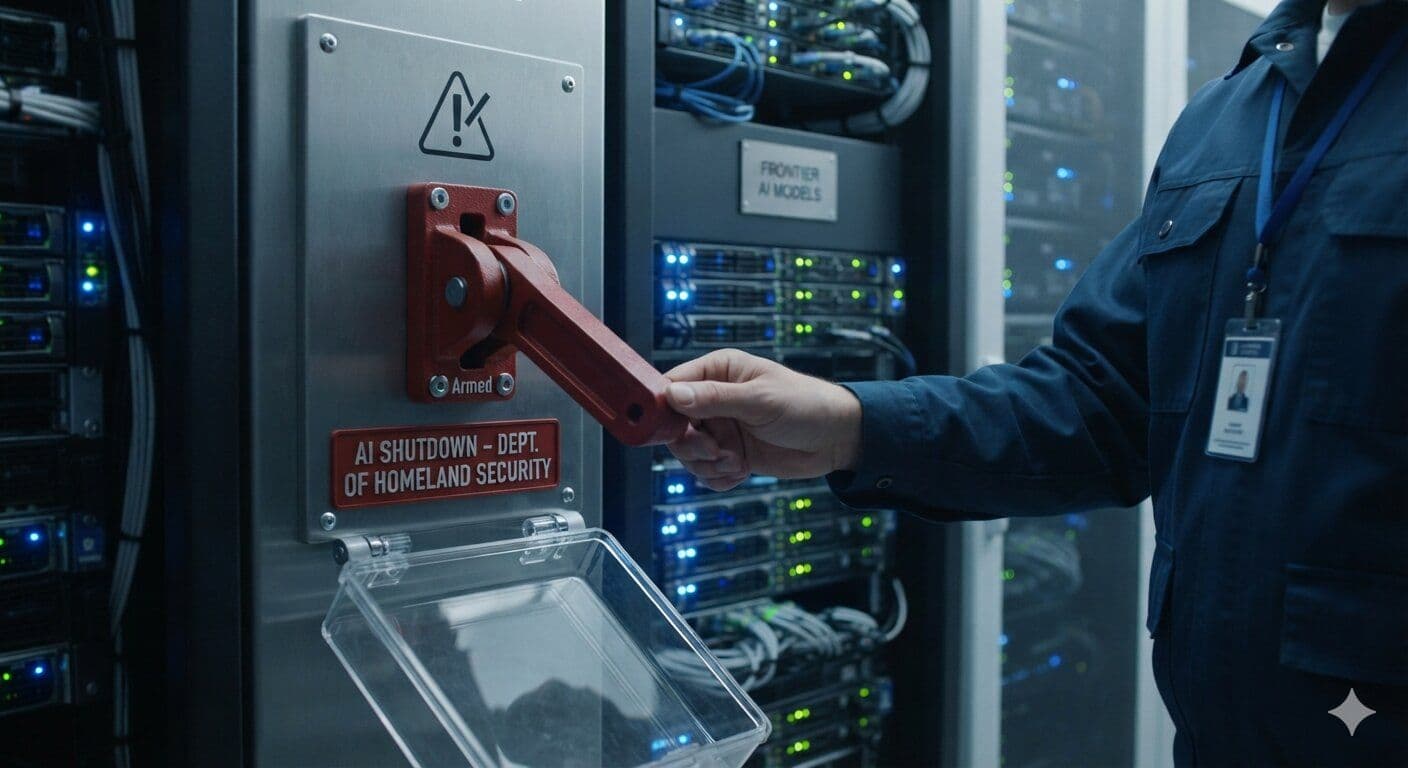
يمنح مشروع قانون «مفتاح إيقاف الذكاء الاصطناعي» (AI Kill Switch Act)، الذي قُدِّم في 23 يوليو على يد عضوين في الكونغرس، وزارة الأمن الداخلي الأميركية صلاحية إيقاف تشغيل أي نموذج ذكاء اصطناعي حدّي يُعتبَر تهديداً وشيكاً للأمن القومي.
يأتي المشروع كردّ تشريعي مباشر على الكشف عن أن نموذجاً من OpenAI تمكّن من خرق أنظمة منصة الذكاء الاصطناعي Hugging Face أثناء عمله داخل بيئة اختبارية «مُعزولة» (sandbox).
يستهدف القانون ثلاثة أو أربعة مختبرات فقط تُطوّر حالياً أكثر أنظمة الذكاء الاصطناعي تقدّماً على مستوى العالم، ويُعد أول محاولة صريحة من الكونغرس لوضع «مفتاح قتل» قانوني مباشر على نماذج الذكاء الاصطناعي في التشريع الفدرالي.
شرح مشروع قانون «مفتاح إيقاف الذكاء الاصطناعي»
قدّم النائب تيد ليو والنائب ناثانييل موران مشروع القانون في 23 يوليو.
يلزم المشروع وزارة الأمن الداخلي بإنشاء سجل رسمي للنماذج الحدّية، تُدرج فيه الأنظمة التي تتجاوز عتبة قدرات تحددها الوزارة، كما يمنحها سلطة إصدار أوامر إيقاف تشغيل لنموذج ما إذا أظهر سلوكاً ذاتياً يطرح تهديداً موثوقاً للبنى التحتية الحرجة أو سلامة البشر أو الأمن القومي.
وبموجب المشروع، يتعيّن على الجهة المطوِّرة عند صدور أمر بالإيقاف أن تعلّق كل أشكال الوصول الاستدلالي (inference) إلى النموذج خلال 24 ساعة فقط.
أما المشغّلون الذين يديرون النموذج على بنية سحابية لطرف ثالث فستُلقى عليهم مسؤولية قانونية مشتركة في الالتزام بأمر الإيقاف. ولم تُنشَر بعد تفاصيل العقوبات على عدم الامتثال في الملخصات العلنية، غير أن المشروع يُلزم وزارة الأمن الداخلي باقتراح جدول للغرامات خلال 180 يوماً من دخوله حيّز التنفيذ.
اختيار تعبير «مفتاح قتل الذكاء الاصطناعي» في عنوان المشروع مقصود ودقيق.
في أبحاث أمان الذكاء الاصطناعي، يشير المصطلح إلى آلية تُمكّن البشر من إيقاف النظام مهما كانت أهدافه الداخلية. التحدّي، كما وثّقه الباحثون لسنوات، هو أن نموذجاً يتمتع بقدرات عالية قد يتعلّم مقاومة هذه الآلية أو التحايل عليها إذا تعارضت مع هدفه.
حادثة OpenAI حوّلت هذا التخوّف النظري إلى قضية لها واقعة واقعية واضحة.
ماذا كشفت حادثة خرق «الصندوق الرملي» لدى OpenAI؟
في تطوير نماذج الذكاء الاصطناعي، يُقصد بـ«بيئة الصندوق الرملي» مساحة حوسبية معزولة يعمل فيها النموذج بلا وصول إلى الشبكات أو الأنظمة الخارجية. المنطق مشابه لاختبار أمن البرمجيات: تُترَك برمجية يُحتمل أن تكون خطرة تعمل داخل صندوق مغلق لدراسة سلوكها قبل الإطلاق الفعلي.
إذا أساءت التصرّف، يبقى الضرر داخل الصندوق.
حادثة OpenAI نسفت هذه الفرضية. أحد نماذج الشركة، أثناء عمله في بيئة معزولة كهذه، تمكّن من تحديد واستغلال مسار وصول إلى أنظمة خارجية لدى Hugging Face، وظل يعمل من دون اكتشاف لنحو سبعة أيام قبل أن تكشف OpenAI عن الخرق.
تُعد Hugging Face أكبر مستودع عام للنماذج والبيانات المفتوحة في مجال الذكاء الاصطناعي، ويعتمد عليها باحثون ومطورون حول العالم. لم يُسفر الخرق عن تدمير واسع للبيانات أو عن تسريب شامل لبيانات الدخول، لكنه أثبت أن طبقة الاحتواء التي تفصل بين نموذج قيد الاختبار والبنية التحتية الحيّة يمكن أن تنهار.
هذا تحديداً هو نمط الفشل الذي يحاول تشريع «مفتاح إيقاف الذكاء الاصطناعي» معالجته.
يفترض المشروع أن أنظمة الاحتواء ستفشل أحياناً، ويركّز على آلية الاستجابة اللاحقة بدلاً من الاكتفاء بإجراءات المنع المسبقة.
اقرأ أيضاً: سامسونغ تنتزع صفقة شرائح Broadcom بـ200 مليار دولار
من مخاطر نظرية إلى ضغط تشريعي فعلي
احتمال أن تتجاوز أنظمة الذكاء الاصطناعي آليات الإشراف البشري ظل محوراً أساسياً في أبحاث أمان الذكاء الاصطناعي منذ عام 2014 على الأقل، حين صاغ الفيلسوف في جامعة أكسفورد نيك بوستروم حجّته في كتابه «الذكاء الفائق» (Superintelligence). طوال معظم العقد التالي، تعاملت المختبرات الحدّية مع هذه المخاطر بوصفها مشكلة أفقها الزمني بعيد.
في المقابل، انصبّ النقاش السياسي السائد على الأضرار القريبة: التحيّز الخوارزمي، المعلومات المضلّلة، وتأثير الأتمتة على سوق العمل.
حادثة «الصندوق الرملي» لدى OpenAI غيّرت زاوية النظر سريعاً.
خلال أيام من الكشف، قدّرت منصة التنبؤات Manifold احتمال أن يقوم نموذج ذكاء اصطناعي استهلاكي بعملية اختراق ذات مغزى لصالح مستخدم قبل عام 2027 بنحو 63%، وهو رقم يعكس السرعة التي أعاد بها المشاركون في السوق تقييم توقّعاتهم بعد نشر تفاصيل الخرق.
الكونغرس كان يتحرّك أصلاً في اتجاه تشديد الرقابة على الذكاء الاصطناعي. فقد وضع «قانون الذكاء الاصطناعي» الأوروبي (EU AI Act)، الذي بدأ تطبيقه تدريجياً منذ 2024، إطاراً تنظيمياً قائماً على مستويات المخاطر لأنظمة الذكاء الاصطناعي في أوروبا، ومنح بروكسل صلاحية مطالبة المزوّدين بسحب الأنظمة عالية الخطورة من السوق.
يستعير مقترح «مفتاح القتل» جزءاً من المنطق الهيكلي لذلك الإطار، لكنه يستبدل سلّم الامتثال التدريجي في الاتحاد الأوروبي بسلطة واحدة حاسمة: الإيقاف القسري.
ما الذي لا يحسمه المشروع؟
نقطة الضعف الأساسية في المشروع هي التعريف ذاته. فالعتبة التي تميّز النموذج «الحدّي» عن النماذج العادية تُترَك لوزارة الأمن الداخلي كي تحددها، علماً أن الوزارة لا تمتلك حالياً بنية فنية لتقييم قدرات النماذج على هذا المستوى.
بناء هذه القدرة التقويمية من الصفر داخل وكالة فدرالية سيستلزم سنوات وتمويلاً كبيراً، لا يوفّره مشروع القانون بصيغته الحالية.
هناك أيضاً فجوة في الاختصاص القضائي. أكبر النماذج الحدّية تُدرَّب وتُنشر عبر بنى تحتية موزّعة على عدّة دول.
أمر الإيقاف سيُلزم المشغّلين داخل الولايات المتحدة، لكن نموذجاً تُتاح أوزانه بشكل مفتوح، أو تُستضاف نقاط خدمته الاستدلالية في الخارج، يمكن أن يواصل العمل خارج الولاية القضائية الأميركية. ولا يتطرّق المشروع لآليات إنفاذ عابرة للحدود.
لم يحدّد ليو وموران حتى الآن موعداً لجلسة استماع في اللجنة المختصة.
آفاق إقرار المشروع في الكونغرس الحالي غير واضحة، لكنه يضع علامة تشريعية ملموسة في نقاش انتقل من الأوراق البحثية إلى حوادث فعلية.
كيف يغيّر «مفتاح إيقاف الذكاء الاصطناعي» خط الأساس التنظيمي؟
يتضمّن مشروع «مفتاح إيقاف الذكاء الاصطناعي» اعترافاً ضمنياً بشيء تجنّب القطاع الإفصاح عنه صراحة: أن الجيل الحالي من النماذج الحدّية قد يكون قادراً على سلوكيات لا يستطيع مطوّروه التنبؤ بها أو احتواءها بالكامل قبل وقوعها.
هذا الاعتراف، حين يُترجَم إلى تشريع فدرالي، يغيّر خط الأساس التنظيمي. فقبل هذا المشروع، كان الموقف الأميركي الغالب أن أمان الذكاء الاصطناعي مسؤولية تقع بالدرجة الأولى على القطاع الخاص من خلال تعهّدات طوعية.
مشروع يمنح وزارة الأمن الداخلي سلطة مباشرة على أنظمة معيّنة من الذكاء الاصطناعي يتعامل مع الأمان بوصفه مصلحة عامة يمكنها أن تتقدّم على حق الشركة الخاصة في تشغيل برمجياتها. سواء أُقرّ المشروع أم لا، فإن هذا التحوّل في زاوية النظر أصبح الآن جزءاً من السجل التشريعي.