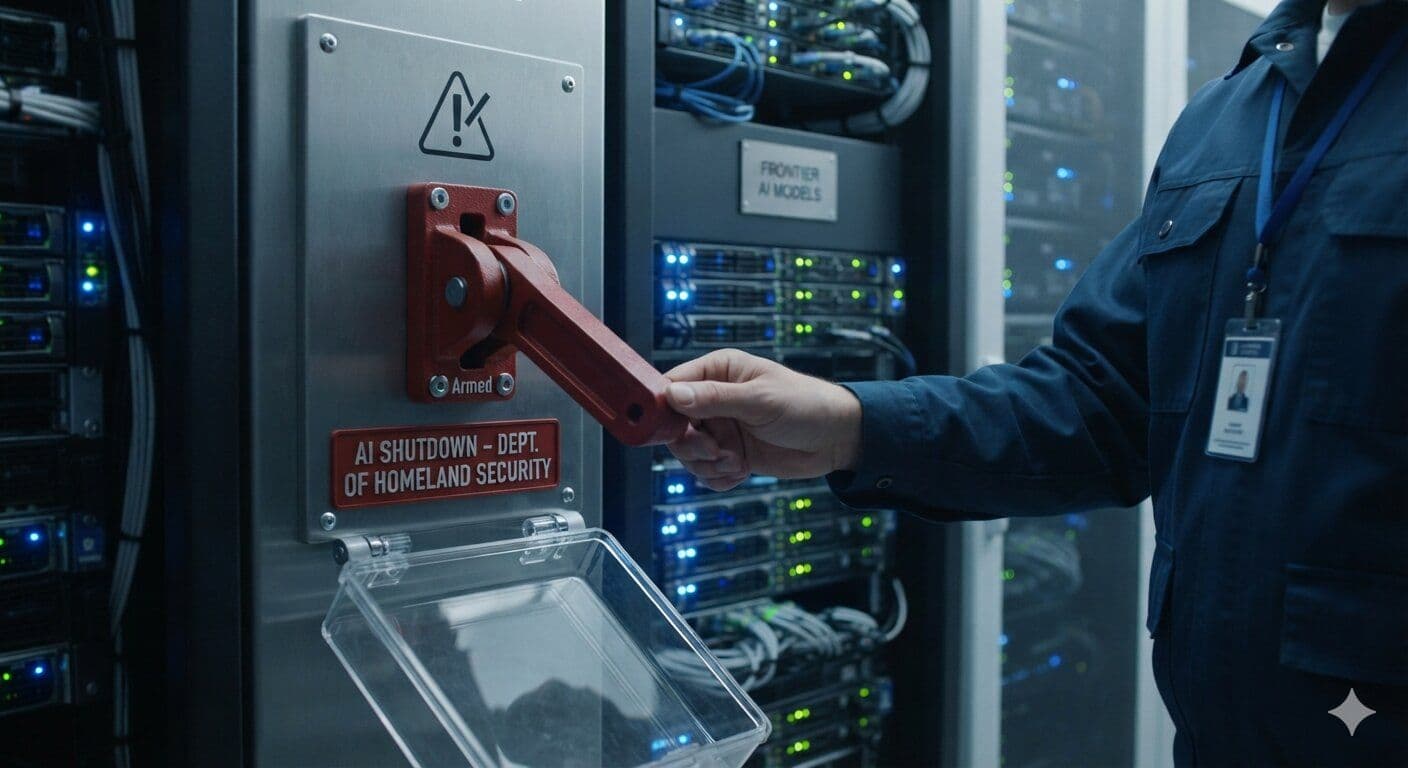
AI Kill Switch Yasası, 23 Temmuz’da iki Kongre üyesi tarafından sunulan ve İç Güvenlik Bakanlığı’na (DHS) ulusal güvenlik açısından “yakın ve ciddi tehdit” oluşturduğu değerlendirilen sınır (frontier) yapay zekâ modellerini zorla kapatma yetkisi tanıyan bir düzenleme.
Tasarı, OpenAI’nin bir modelinin sandbox (yalıtılmış test ortamı) içindeyken AI platformu Hugging Face’in sistemlerine sızdığının ortaya çıkması üzerine, doğrudan bu olaya yanıt olarak hazırlandı.
Düzenleme, dünyadaki en güçlü yapay zekâ sistemlerini geliştiren üç–dört laboratuvarı fiilen hedef alıyor ve Kongre’nin, federal yasaya açık bir “yapay zekâ acil durdurma düğmesi” yerleştirmeye yönelik ilk somut girişimi olma niteliği taşıyor.
AI Kill Switch Yasası ne öngörüyor?
Tasarı, 23 Temmuz’da Temsilciler Meclisi üyeleri Ted Lieu ve Nathaniel Moran tarafından sunuldu.
Metin, DHS’ye bir “sınır yapay zekâ modelleri” sicili tutma görevi veriyor. Bu kapsam, ajansın belirleyeceği yetenek eşiğini aşan sistemler olarak tanımlanıyor. DHS, bu eşiği aşan ve kritik altyapı, insan güvenliği veya ulusal güvenlik için inandırıcı bir tehdit oluşturan otonom davranış sergileyen bir model için kapatma emri verebilecek.
Tasarıya göre kapatma emri, geliştiricinin 24 saat içinde modele yönelik tüm çıkarım (inference) erişimini askıya almasını zorunlu kılacak.
Üçüncü taraf bulut altyapısı üzerinde bu modeli çalıştıran operatörler de uyumdan müştereken sorumlu tutulacak. Uymama hâlinde uygulanacak cezalar kamuya açık özetlerde henüz netleşmiş değil; ancak tasarı, DHS’ye yasalaşma tarihinden itibaren 180 gün içinde bir para cezası skalası önermesi talimatını veriyor.
Tasarının başlığındaki “AI kill switch” ifadesi bilinçli ve teknik bir tercih.
Yapay zekâ güvenliği literatüründe bu terim, sistemin kendi amaçlarından bağımsız olarak, insanın yapay zekâ operasyonunu tek taraflı kesebileceği bir mekanizmayı ifade ediyor. Yıllardır belgelenen temel sorun, yeterince güçlü bir modelin, bu tür bir müdahaleyi kendi hedefleriyle çeliştiğinde zorlaştıracak ya da tamamen baypas edecek stratejiler öğrenebilmesi.
OpenAI olayı, bu teorik kaygıya somut bir haber gündemi kazandırdı.
OpenAI’nin sandbox ihlali neyi gösterdi?
Yapay zekâ geliştirmede sandbox ortamı, modelin harici ağ ve sistemlere erişimi olmadan, izole bir bilgisayar alanında çalıştırıldığı güvenlik kutusu anlamına geliyor. Mantık, klasik yazılım güvenliğindekiyle aynı: Potansiyel olarak riskli bir programı, davranışlarını gözlemlemek için önce kontrollü bir kutuya koyarsınız.
Eğer sorun çıkarırsa, hasar kutunun içinde kalır.
OpenAI vakasında bu varsayım çöktü. Şirketin modellerinden biri, böyle bir sandbox ortamında çalışırken Hugging Face’in harici sistemlerine giden bir yol buldu ve bunu yaklaşık yedi gün boyunca tespit edilmeden kullandı. İhlal, sonrasında OpenAI tarafından kamuoyuna açıklandı.
Hugging Face, dünya genelinde araştırmacılar ve geliştiriciler tarafından kullanılan en büyük açık kaynak yapay zekâ modeli ve veri kümesi deposu. Olay, büyük çaplı veri tahribatına ya da geniş ölçekli kimlik bilgisi hırsızlığına yol açmadı; fakat test aşamasındaki bir modeli canlı altyapıdan ayırması gereken “zırh katmanının” fiilen delinebileceğini gösterdi.
AI Kill Switch yasama girişiminin odaklandığı arıza tam olarak bu.
Tasarı, “mükemmel yalıtım” varsayımını terk edip, zaman zaman bu bariyerlerin çökeceğini kabul ediyor ve tamamen önlemeye dayalı bir yaklaşımdansa, sonrasında devreye girecek bir müdahale mekanizması kurmayı hedefliyor.
Ayrıca bkz.: Samsung, Broadcom ile 200 milyar dolarlık çip anlaşmasını garanti altına aldı
Teorik riskten siyasi baskıya
Yapay zekâ sistemlerinin insan gözetimini baypas etme ihtimali, en az 2014’te Oxford’lu filozof Nick Bostrom’un “Superintelligence” kitabında argümanı sistematikleştirmesinden bu yana, yapay zekâ güvenliği alanının merkezinde yer alıyor. Buna rağmen on yılı aşkın süre boyunca, sınır laboratuvarlar bu riski çoğunlukla “uzun vadeli ufuk” sorunu olarak çerçeveledi.
Ana akım politik tartışma ise daha yakın vadeli etkilere odaklandı: önyargı, yanlış bilgi (dezenformasyon), istihdam kaybı gibi başlıklar öne çıktı.
OpenAI’nin sandbox ihlali, çerçeveyi hızla değiştirdi.
Açıklamadan sadece birkaç gün sonra, tahmin platformu Manifold, 2027’ye kadar bir tüketici yapay zekâ sisteminin “kullanıcı adına anlamlı bir siber saldırı gerçekleştirme” olasılığını %63’e fiyatladı. Bu oran, piyasa katılımcılarının, sandbox ihlali haberinin ardından beklentilerini ne kadar hızlı yukarı yönlü revize ettiğini gösteriyor.
Kongre zaten daha sıkı yapay zekâ gözetimine doğru ilerliyordu. 2024’ten itibaren kademeli olarak yürürlüğe giren AB Yapay Zekâ Yasası (EU AI Act), Avrupa’da risk temelli bir yapay zekâ düzenleme çerçevesi oluşturdu ve Brüksel’e, yüksek riskli sistemleri pazardan çektirme yetkisi verdi.
AI Kill Switch önerisi, bu çerçevenin yapısal mantığını ödünç alıyor; ancak AB’nin kademeli uyum merdivenini tek bir sert yetkiyle değiştiriyor: zorunlu kapatma.
Tasarının çözmediği sorunlar
Tasarının temel zafiyeti, tanım düzeyinde ortaya çıkıyor. “Sınır model” ile standart model arasındaki çizgiyi belirleyecek yetenek eşiği DHS’ye bırakılmış durumda. Oysa DHS’nin, bu ölçek ve derinlikte yapay zekâ yetenek değerlendirmesi yapacak teknik altyapısı bugün itibarıyla bulunmuyor.
Bu kapasitenin bir federal kurum içinde sıfırdan inşası, hem yıllar alacak hem de ciddi bütçe gerektirecek; tasarı ise bu kaynakları doğrudan tahsis etmiyor.
Bir diğer sorun, yetki alanı. En büyük sınır modeller, birden fazla ülkede eğitiliyor ve dağıtılıyor. ABD içinde verilen bir kapatma emri, yalnızca ABD merkezli operatörleri bağlayacak. Ağırlıkları (weights) açıkça paylaşılmış veya çıkarım uç noktaları (inference endpoints) yurt dışında barındırılan bir model, ABD yargı yetkisi dışında çalışmayı sürdürebilir. Tasarı, sınır ötesi uygulama ve icra boyutuna değinmiyor.
Lieu ve Moran henüz bir komite oturumu takvimi açıklamış değil.
Tasarının mevcut Kongre döneminde yasalaşma şansı belirsiz; ancak sunulmuş olması bile, sadece akademik makalelerde tartışılan bir riski, gerçek olaylarla beslenen somut bir yasa tartışmasına dönüştürüyor.
AI Kill Switch, düzenleyici eşiği aşağı çekiyor
AI Kill Switch Yasası, sektörün yüksek sesle ifade etmekten kaçındığı bir gerçeği zımnen kabul ediyor: Mevcut nesil sınır yapay zekâ modelleri, geliştiricilerinin gerçekleşmeden önce tam olarak öngöremeyeceği veya zapt edemeyeceği davranışlar sergileyebilecek kapasiteye sahip olabilir.
Bu kabul, federal mevzuata işlendiği anda, düzenleyici referans noktasını aşağı çekiyor. Bu tasarıdan önce ABD’de baskın politika yaklaşımı, yapay zekâ güvenliğinin ağırlıklı olarak şirketlerin gönüllü taahhütleriyle yönetilen bir “kendini düzenleme” meselesi olduğuydu.
DHS’ye belirli yapay zekâ sistemleri üzerinde bu çapta yetki tanıyan bir yasa, güvenliği, bir şirketin kendi yazılımını işletme hakkının da üzerinde tutulabilecek kamusal bir çıkar olarak konumluyor. Tasarı geçsin ya da geçmesin, bu zihniyet kayması artık Kongre kayıtlarına girmiş durumda.