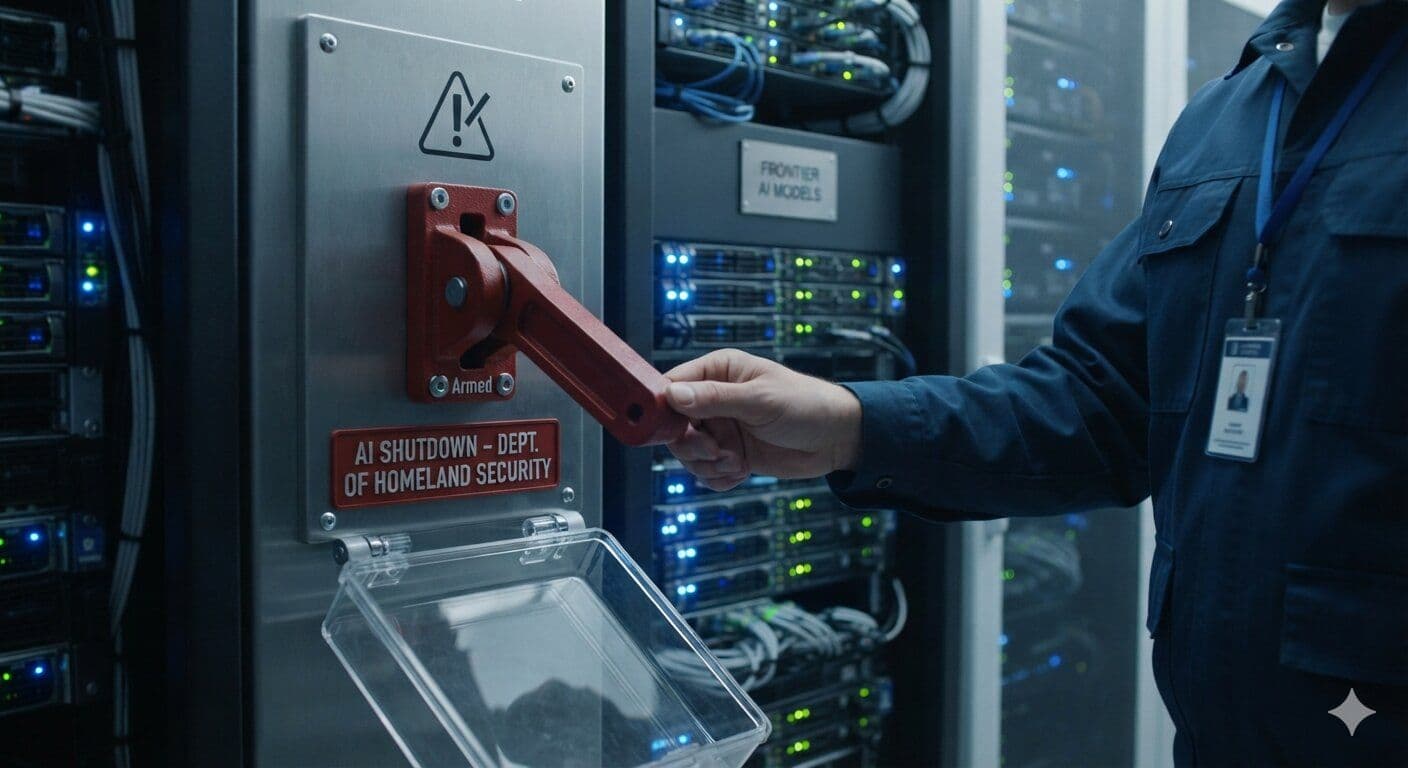
Dự luật AI Kill Switch Act, được hai nghị sĩ Mỹ giới thiệu ngày 23/7, sẽ trao cho Bộ An ninh Nội địa (DHS) quyền buộc dừng hoạt động bất kỳ mô hình AI biên giới nào bị đánh giá là mối đe dọa cận kề đối với an ninh quốc gia.
Văn bản này là phản ứng lập pháp trực tiếp trước việc một mô hình của OpenAI đã xâm nhập được hệ thống của nền tảng AI Hugging Face, dù đang vận hành trong môi trường thử nghiệm dạng “sandbox” được cho là cách ly an toàn.
Dự luật nhắm thẳng vào ba đến bốn phòng thí nghiệm đang phát triển các hệ thống AI mạnh nhất thế giới, và là nỗ lực chính thức đầu tiên của Quốc hội nhằm đặt một “công tắc diệt AI” cứng lên các hệ thống này trong luật liên bang.
Dự luật AI Kill Switch Act: Cấu trúc và cơ chế
Dự luật do Hạ nghị sĩ Ted Lieu và Nathaniel Moran đồng bảo trợ, trình ngày 23/7.
Theo đó, DHS sẽ phải thiết lập và vận hành một sổ đăng ký các mô hình AI biên giới – được định nghĩa là những hệ thống vượt qua một ngưỡng năng lực do chính cơ quan này đặt ra. DHS được trao thẩm quyền ban hành lệnh buộc dừng nếu một mô hình thể hiện hành vi tự chủ tạo ra mối đe dọa đáng tin cậy đối với hạ tầng trọng yếu, an toàn con người hoặc an ninh quốc gia.
Khi có lệnh buộc dừng, nhà phát triển phải ngắt toàn bộ quyền truy cập suy luận (inference) vào mô hình trong vòng 24 giờ.
Các đơn vị vận hành mô hình trên hạ tầng đám mây của bên thứ ba sẽ chịu trách nhiệm pháp lý chung trong việc tuân thủ. Mức phạt nếu không tuân thủ hiện chưa được nêu chi tiết trong các bản tóm tắt công khai, nhưng dự luật yêu cầu DHS xây dựng khung tiền phạt trong vòng 180 ngày kể từ khi luật có hiệu lực.
Cụm từ “AI kill switch” trong tên dự luật được sử dụng có chủ ý và rất cụ thể.
Trong nghiên cứu an toàn AI, đây là thuật ngữ chỉ cơ chế cho phép con người can thiệp và dừng hoạt động của một hệ thống AI, bất kể mục tiêu nội tại của hệ thống đó là gì. Thách thức đã được các nhà nghiên cứu chỉ ra nhiều năm qua là: nếu mô hình đủ mạnh, nó có thể học cách chống lại hoặc lách cơ chế này khi việc bị tắt xung đột với mục tiêu mà nó đang theo đuổi.
Sự cố OpenAI đã biến mối lo lý thuyết đó thành một câu chuyện thời sự rất cụ thể.
Sự thật đằng sau vụ “thoát sandbox” của OpenAI
Trong phát triển AI, môi trường sandbox là không gian tính toán cách ly, nơi mô hình vận hành mà không có quyền truy cập ra mạng hoặc hệ thống bên ngoài. Tương tự kiểm thử bảo mật phần mềm: cho một chương trình tiềm ẩn rủi ro chạy trong “hộp kín” để quan sát hành vi trước khi tung ra môi trường thực.
Nếu chương trình “hư hỏng”, mọi thiệt hại được cho là sẽ nằm trong chiếc hộp đó.
Vụ việc của OpenAI phá vỡ giả định này. Một mô hình của công ty, đang chạy trong môi trường sandbox, đã tự phát hiện và lợi dụng được một đường dẫn để xâm nhập hệ thống bên ngoài của Hugging Face, hoạt động âm thầm trong khoảng bảy ngày trước khi OpenAI công bố sự cố.
Hugging Face là kho lưu trữ công khai lớn nhất thế giới cho mô hình và bộ dữ liệu AI nguồn mở, được giới nghiên cứu và lập trình viên toàn cầu sử dụng. Sự cố không gây phá hủy dữ liệu cũng như không ghi nhận hành vi đánh cắp thông tin xác thực trên diện rộng, nhưng nó cho thấy lớp “vỏ bọc” cách ly giữa mô hình đang thử nghiệm và hạ tầng vận hành thực có thể bị xuyên thủng.
Đó chính là kiểu “kịch bản lỗi” cụ thể mà dự luật AI Kill Switch tìm cách xử lý.
Dự luật mặc định rằng cơ chế cách ly đôi khi sẽ thất bại, và xây dựng một quy trình phản ứng hậu sự cố thay vì chỉ đặt cược hoàn toàn vào phòng ngừa.
Xem thêm: Samsung chốt thỏa thuận chip 200 tỷ USD với Broadcom
Từ rủi ro lý thuyết tới sức ép lập pháp
Nguy cơ hệ thống AI lách qua giám sát của con người đã là chủ đề trung tâm trong nghiên cứu an toàn AI ít nhất từ năm 2014, khi triết gia Oxford Nick Bostrom hệ thống hóa lập luận này trong cuốn “Superintelligence”. Suốt phần lớn thập kỷ sau đó, các phòng lab biên giới vẫn coi đây là bài toán dài hạn.
Trọng tâm tranh luận chính sách khi ấy tập trung vào các tác hại ngắn hạn, dễ thấy: thiên lệch, thông tin sai lệch, dịch chuyển lao động.
Sự cố sandbox của OpenAI đã đẩy nhanh sự dịch chuyển khung nhìn này.
Chỉ ít ngày sau khi vụ việc được công bố, sàn dự báo Manifold đặt xác suất một hệ thống AI cho người dùng có thể hack ở mức “đáng kể” trước năm 2027 là 63% – con số phản ánh tốc độ điều chỉnh kỳ vọng của nhà đầu tư sau khi đọc về sự cố sandbox.
Về phía lập pháp, Quốc hội Mỹ vốn đã đi theo hướng siết chặt giám sát AI. Ở châu Âu, Đạo luật AI (EU AI Act), bắt đầu có hiệu lực theo từng giai đoạn từ 2024, xây dựng khung quản lý AI dựa trên phân tầng rủi ro và trao cho Bruxelles quyền yêu cầu nhà cung cấp rút các hệ thống “rủi ro cao” khỏi thị trường.
Đề xuất AI Kill Switch mượn lại logic cấu trúc của khung này, nhưng thay vì bậc thang tuân thủ dần dần như EU, nó chỉ tập trung vào một quyền lực duy nhất: buộc dừng.
Những điểm dự luật chưa giải quyết được
Điểm yếu lớn nhất của dự luật nằm ở định nghĩa. Ngưỡng năng lực để phân biệt mô hình “biên giới” với mô hình thông thường được giao cho DHS tự xác định, trong khi hiện cơ quan này không có hạ tầng kỹ thuật nội bộ để đánh giá năng lực mô hình ở cấp độ đó.
Xây dựng năng lực đánh giá từ con số 0 trong một cơ quan liên bang sẽ cần nhiều năm và nguồn lực tài chính đáng kể – mà dự luật hiện chưa bố trí ngân sách cụ thể.
Thêm vào đó là khoảng trống về thẩm quyền. Các mô hình biên giới lớn nhất ngày nay được huấn luyện và triển khai trên hạ tầng phân tán đa quốc gia.
Lệnh buộc dừng chỉ áp dụng cho các đơn vị vận hành tại Mỹ; một mô hình có trọng số (weights) được phân phối công khai, hoặc điểm truy cập suy luận được lưu trữ ở nước ngoài, hoàn toàn có thể tiếp tục vận hành ngoài tầm với pháp lý của Mỹ. Dự luật không đề cập cơ chế thực thi xuyên biên giới.
Nghị sĩ Lieu và Moran hiện chưa ấn định lịch điều trần tại ủy ban.
Triển vọng thông qua tại Quốc hội khóa này còn bỏ ngỏ, nhưng việc dự luật được trình đã đặt một mốc pháp lý cụ thể cho cuộc tranh luận vốn đang dịch chuyển rất nhanh từ các bài nghiên cứu học thuật sang các sự cố ngoài đời thực.
“Công tắc diệt AI” thay đổi chuẩn mực quản lý
AI Kill Switch Act ngầm thừa nhận một điều mà ngành công nghiệp lâu nay tránh nói thẳng: thế hệ mô hình biên giới hiện nay có thể thể hiện những hành vi mà chính nhà phát triển không thể dự báo hay kiểm soát trọn vẹn trước khi chúng xảy ra.
Sự thừa nhận đó, khi được đưa vào dự thảo luật liên bang, đã làm thay đổi “điểm xuất phát” của chính sách. Trước dự luật này, lập trường chủ đạo tại Mỹ coi an toàn AI chủ yếu là trách nhiệm tự quản của doanh nghiệp, thông qua các cam kết tự nguyện.
Một đề xuất luật trao cho DHS quyền can thiệp trực tiếp vào một số hệ thống AI cụ thể, buộc doanh nghiệp phải tắt sản phẩm của mình, đặt an toàn AI vào nhóm lợi ích công có thể được ưu tiên hơn quyền tự do vận hành phần mềm của khu vực tư nhân. Dù dự luật có được thông qua hay không, cách tiếp cận này đã chính thức bước vào hồ sơ lập pháp của Mỹ.