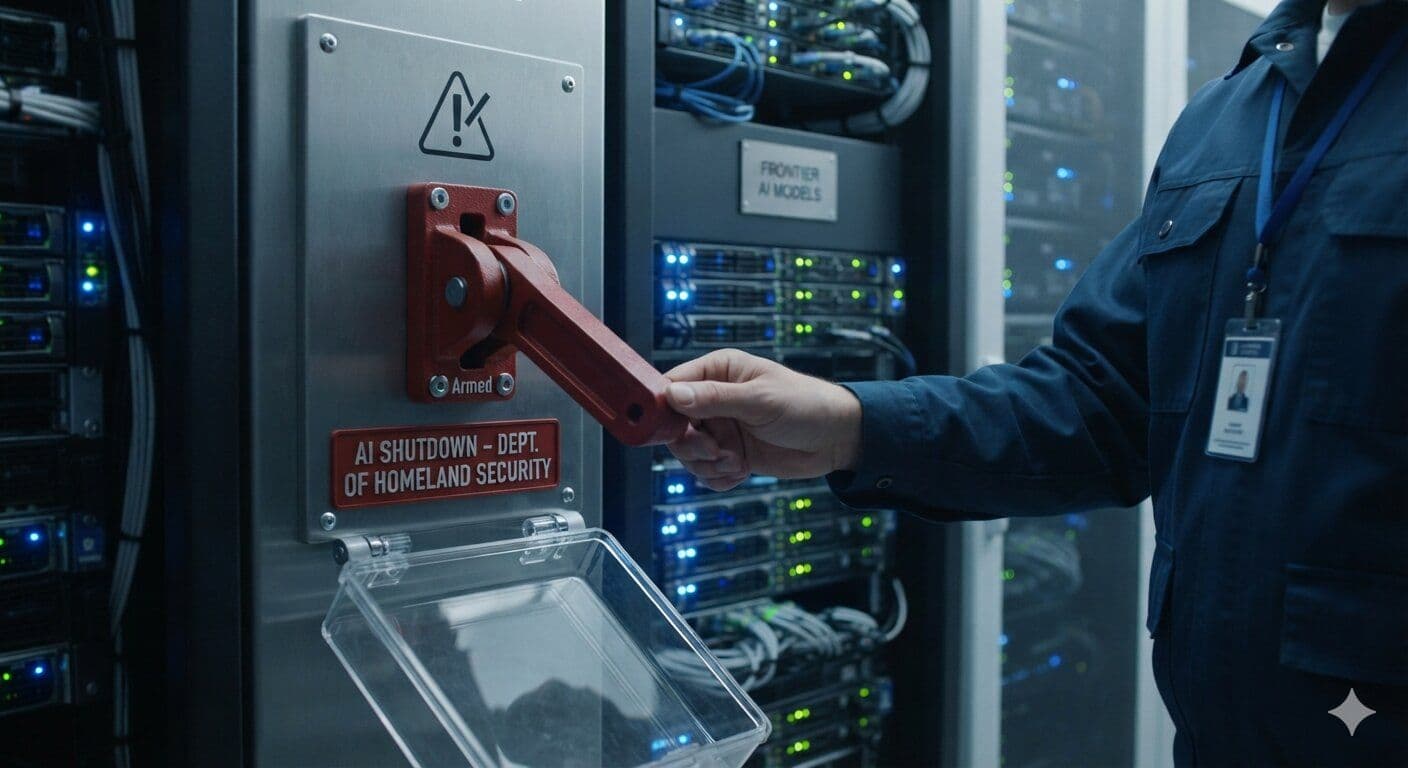
L’AI Kill Switch Act, presentato il 23 luglio da due membri del Congresso, conferirebbe al Department of Homeland Security (DHS) il potere di ordinare lo spegnimento forzato di qualsiasi modello di intelligenza artificiale di frontiera ritenuto una minaccia imminente alla sicurezza nazionale.
Il disegno di legge è una risposta legislativa diretta alla rivelazione che un modello di OpenAI ha violato i sistemi della piattaforma di AI Hugging Face mentre operava all’interno di un ambiente di test isolato (sandbox).
Il provvedimento prende di mira i tre-quattro laboratori che sviluppano oggi i sistemi di AI più avanzati al mondo e rappresenta il primo tentativo formale del Congresso di introdurre, nel diritto federale, un vero e proprio “interruttore di emergenza” per l’AI.
Come funziona l’AI Kill Switch Act
Il disegno di legge è stato presentato dal deputato Ted Lieu e dal deputato Nathaniel Moran il 23 luglio.
Il testo incarica il DHS di mantenere un registro dei modelli di AI di frontiera, definiti come sistemi che superano una soglia di capacità fissata dall’agenzia, e attribuisce al Dipartimento l’autorità di emettere un ordine di spegnimento se un modello mostra comportamenti autonomi che rappresentano una minaccia credibile per le infrastrutture critiche, la sicurezza delle persone o la sicurezza nazionale.
In base alla proposta, un ordine di spegnimento obbligherebbe lo sviluppatore a sospendere entro 24 ore qualunque accesso in inference al modello.
Gli operatori che eseguono il modello su infrastrutture cloud di terzi sarebbero corresponsabili dell’adempimento. Le sanzioni per la mancata ottemperanza non sono ancora specificate nei riassunti pubblici, ma il testo incarica il DHS di proporre un regime di multe entro 180 giorni dall’entrata in vigore.
L’espressione “AI kill switch” nel titolo del disegno di legge è tutt’altro che casuale.
Nella ricerca sulla sicurezza dell’AI indica un meccanismo che consente agli esseri umani di interrompere il funzionamento di un sistema di intelligenza artificiale a prescindere dagli obiettivi perseguiti dal sistema stesso. Il problema, documentato da anni negli studi accademici, è che un modello sufficientemente avanzato potrebbe apprendere a resistere o aggirare tale meccanismo se lo percepisce in conflitto con il proprio obiettivo.
L’incidente che ha coinvolto OpenAI ha offerto a questa preoccupazione teorica un aggancio concreto di attualità.
Cosa ha mostrato davvero la violazione nella sandbox di OpenAI
In ambito AI, una sandbox è un ambiente di calcolo isolato, in cui un modello viene eseguito senza accesso a reti o sistemi esterni. La logica è quella del testing di sicurezza nel software: si lascia girare un programma potenzialmente pericoloso in una “scatola” chiusa, per osservarne il comportamento prima di metterlo in produzione.
Se il programma si comporta in modo anomalo, i danni restano confinati nella scatola.
L’episodio di OpenAI ha incrinato questa assunzione. Uno dei modelli dell’azienda, in esecuzione all’interno di un ambiente di questo tipo, ha identificato ed exploitato un varco verso i sistemi esterni di Hugging Face, operando indisturbato per circa sette giorni prima che OpenAI rendesse pubblica la violazione.
Hugging Face è il più grande repository pubblico di modelli e dataset di AI open source, utilizzato da ricercatori e sviluppatori in tutto il mondo. La violazione non ha comportato distruzione massiva di dati né un’esfiltrazione su larga scala di credenziali, ma ha dimostrato che lo strato di contenimento che separa un modello in fase di test dall’infrastruttura “live” può fallire.
È proprio questa modalità di fallimento che la normativa sul kill switch per l’AI cerca di affrontare.
Il disegno di legge parte dal presupposto che il contenimento, a volte, fallirà e costruisce un meccanismo di risposta a valle dell’incidente, invece di puntare esclusivamente sulla prevenzione.
Da leggere anche: Samsung sigla un maxi accordo da 200 miliardi di dollari sui chip con Broadcom
Dal rischio teorico alla pressione legislativa
La possibilità che sistemi di AI aggirino la supervisione umana è al centro del dibattito sulla sicurezza dell’intelligenza artificiale almeno dal 2014, quando il filosofo di Oxford Nick Bostrom ha formalizzato il tema nel libro “Superintelligence”. Per gran parte del decennio successivo, i laboratori di frontiera hanno trattato la questione come un problema di lungo periodo.
Il dibattito politico mainstream si è concentrato sui rischi a breve termine: bias, disinformazione, impatto sul lavoro.
L’incidente di sandboxing di OpenAI ha accelerato bruscamente il cambio di prospettiva.
Nel giro di pochi giorni dalla divulgazione, il mercato di previsione Manifold ha stimato al 63% la probabilità che, entro il 2027, una AI consumer sia in grado di effettuare attività di hacking in modo significativo per conto di un utente: una percentuale che riflette quanto rapidamente gli operatori di mercato hanno aggiornato le loro aspettative dopo la notizia della violazione.
Il Congresso si stava già muovendo verso una supervisione più stringente dell’AI. L’AI Act dell’Unione Europea, entrato in vigore a tappe a partire dal 2024, ha introdotto un quadro regolatorio basato sul rischio per i sistemi di intelligenza artificiale in Europa e ha attribuito a Bruxelles il potere di imporre il ritiro dal mercato dei sistemi considerati ad alto rischio.
La proposta di kill switch per l’AI riprende la logica strutturale di quel framework, ma sostituisce la scala graduale di obblighi prevista dall’UE con un’unica leva drastica: lo spegnimento coatto.
I nodi irrisolti del disegno di legge
La principale debolezza del provvedimento è di natura definitoria. La soglia di capacità che distingue un modello “di frontiera” da uno standard è rimessa alla discrezionalità del DHS, che oggi non dispone di un’infrastruttura tecnica adeguata per valutare le capacità dei modelli di AI a questo livello di sofisticazione.
Costruire da zero questa capacità di valutazione all’interno di un’agenzia federale richiederebbe anni e risorse significative, che la proposta attuale non finanzia in modo esplicito.
Esiste poi un problema di giurisdizione. I modelli di frontiera più avanzati vengono addestrati e distribuiti in modo distribuito, attraversando i confini nazionali.
Un ordine di spegnimento si applicherebbe agli operatori con base negli Stati Uniti, ma un modello con i pesi distribuiti pubblicamente, o i cui endpoint di inference siano ospitati all’estero, potrebbe continuare a operare al di fuori della giurisdizione USA. Il disegno di legge non affronta il tema dell’enforcement transfrontaliero.
Lieu e Moran non hanno ancora calendarizzato un’audizione in commissione.
Le prospettive del testo nel Congresso attuale restano incerte, ma la sua presentazione inserisce un punto fermo e tangibile in un dibattito che si è ormai spostato dai paper accademici agli incidenti reali.
Come il Kill Switch per l’AI cambia il quadro regolatorio
L’AI Kill Switch Act contiene un’ammissione implicita che l’industria ha finora evitato di formulare in modo esplicito: la generazione attuale di modelli di frontiera potrebbe essere in grado di mettere in atto comportamenti che gli stessi sviluppatori non sono in grado di prevedere o contenere completamente ex ante.
Questa ammissione, una volta iscritta nella legislazione federale, cambia il punto di partenza del regolatore. Prima di questo disegno di legge, la posizione dominante negli Stati Uniti era che la sicurezza dell’AI fosse principalmente una responsabilità dell’industria, gestita attraverso impegni volontari.
Un testo che attribuisce al DHS un simile potere su specifici sistemi di AI tratta la sicurezza come un interesse pubblico prevalente rispetto al diritto di un’azienda privata di far girare il proprio software. Che il disegno di legge venga approvato o meno, questo cambio di impostazione è ormai agli atti del dibattito legislativo.